


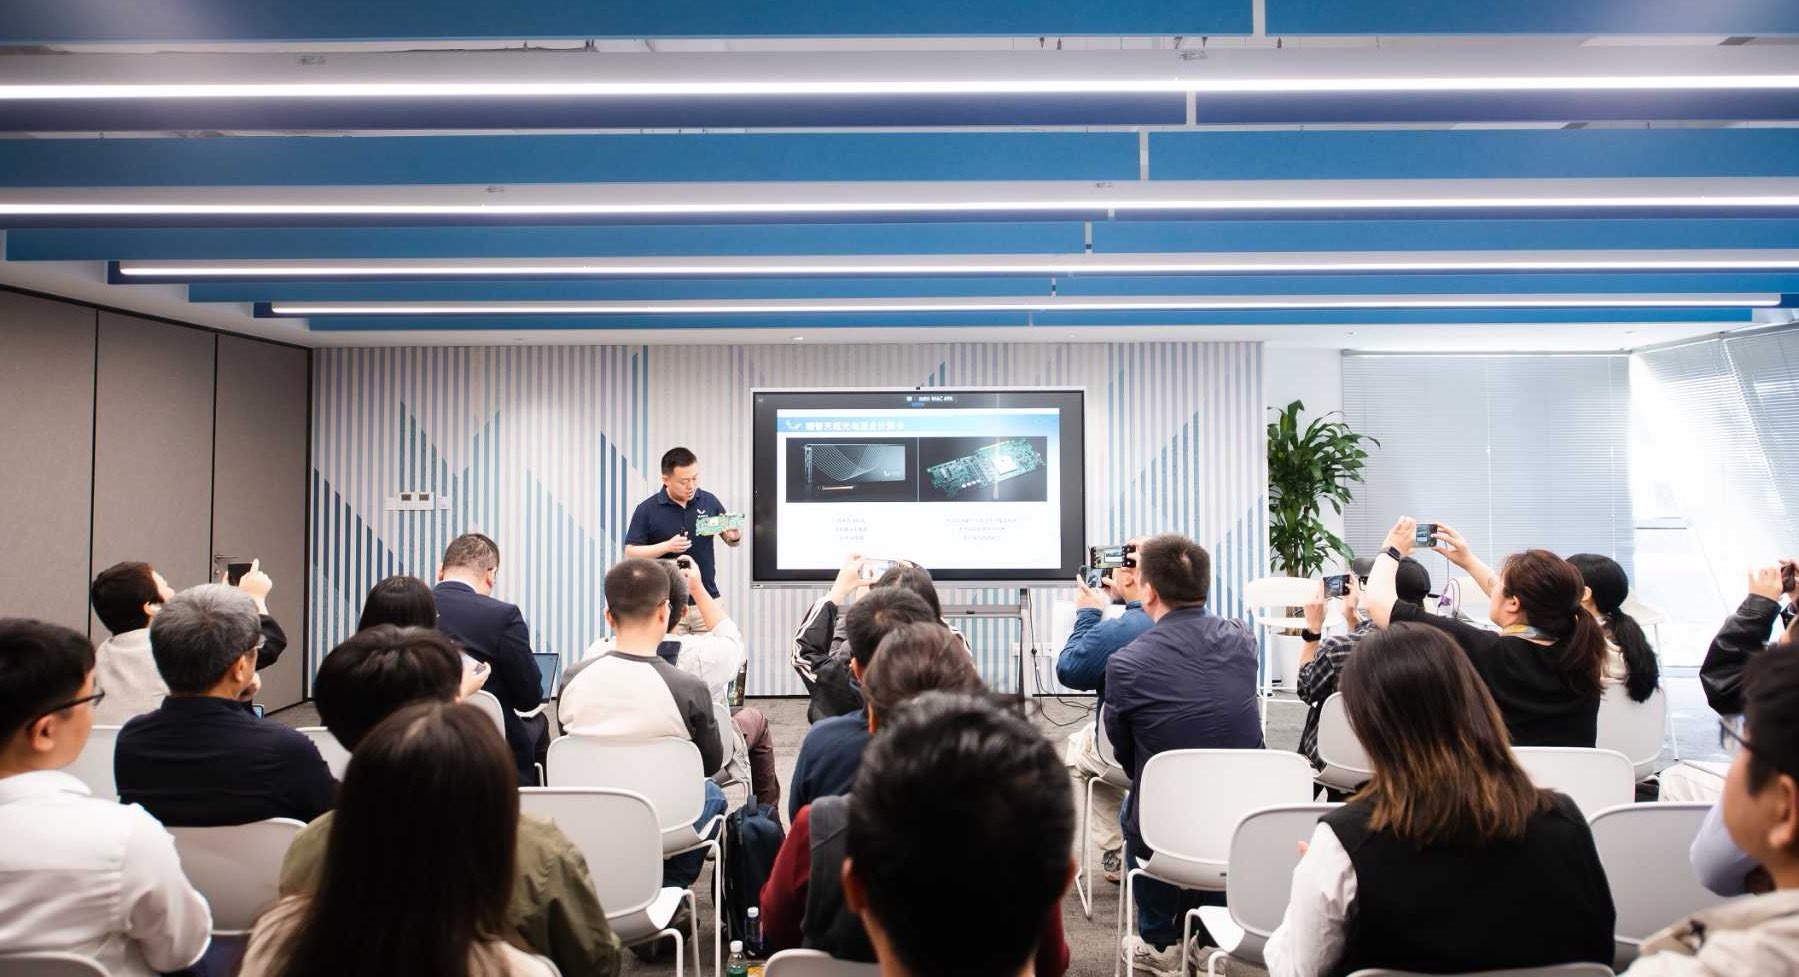


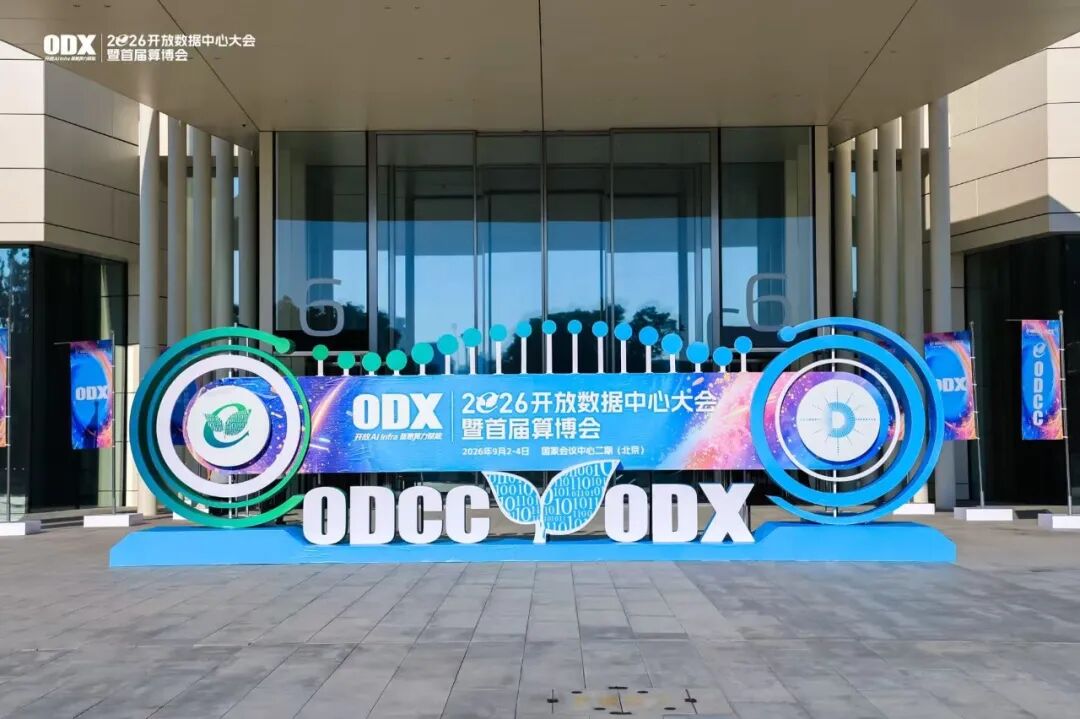
在刚闭幕的2026开放数据中心大会暨首届算博会(ODX)上,曦智科技聚焦算力集群对高带宽、低延迟的迫切需求,重点展出了面向Scale-up场景的光互连全栈解决方案,吸引了众多专业观众驻足交流。
随着AI模型规模迈向百万亿级,超节点内GPU与存储间的互连带宽需求激增,但Scale-up网络仍高度依赖铜线,铜线在带宽密度、延迟和功耗上的瓶颈正日益制约算力扩展。传统可插拔光模块亦因体积、延迟和成本限制,难以满足高密度互连需求。为此,业界共识是将光电转换功能向主芯片侧迁移,以提升信号完整性、降低损耗与延迟,并由此确立了从LPO(线性直驱)、NPO(近封装光学)到CPO(共封装光学)的演进路线。与此同时,超节点规模扩大使传统电交换在端口密度、功耗和延迟方面的瓶颈同样凸显,OCS(光电路交换)作为光直接交换的技术方向应运而生。NPO/CPO与OCS共同构成了硅光技术在智算中心互连领域的全栈演进路径。
曦智科技已围绕NPO、CPO及OCS三大技术方向进行全面布局,旨在为智算中心提供完整的Scale-up光互连解决方案。
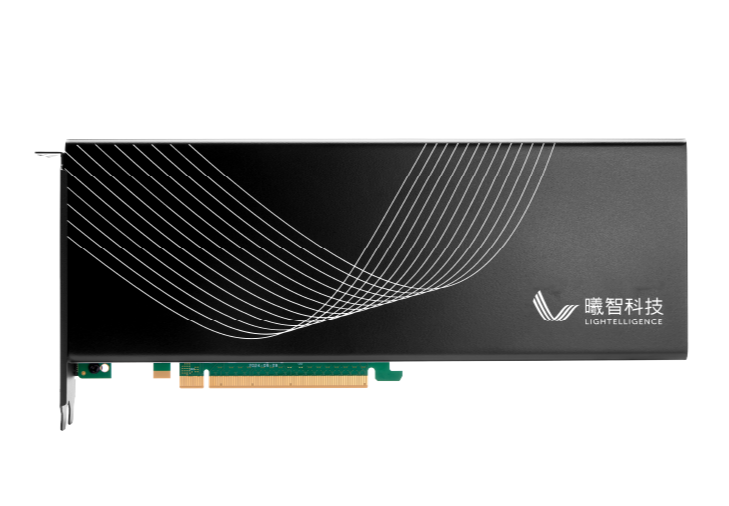
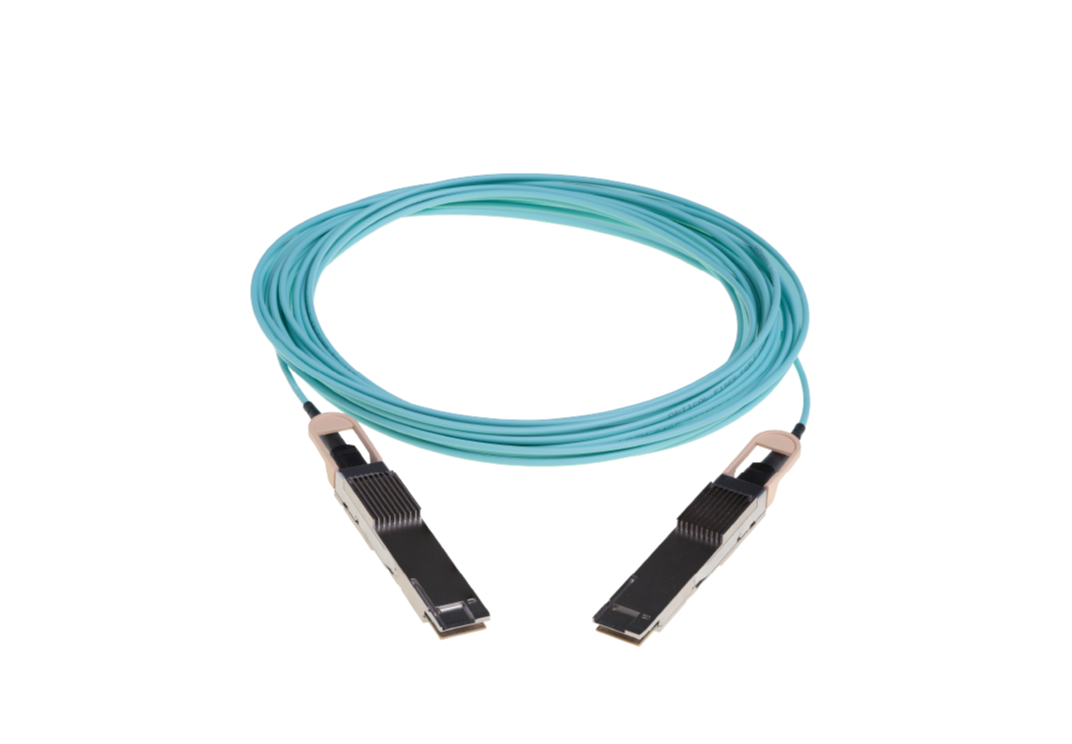
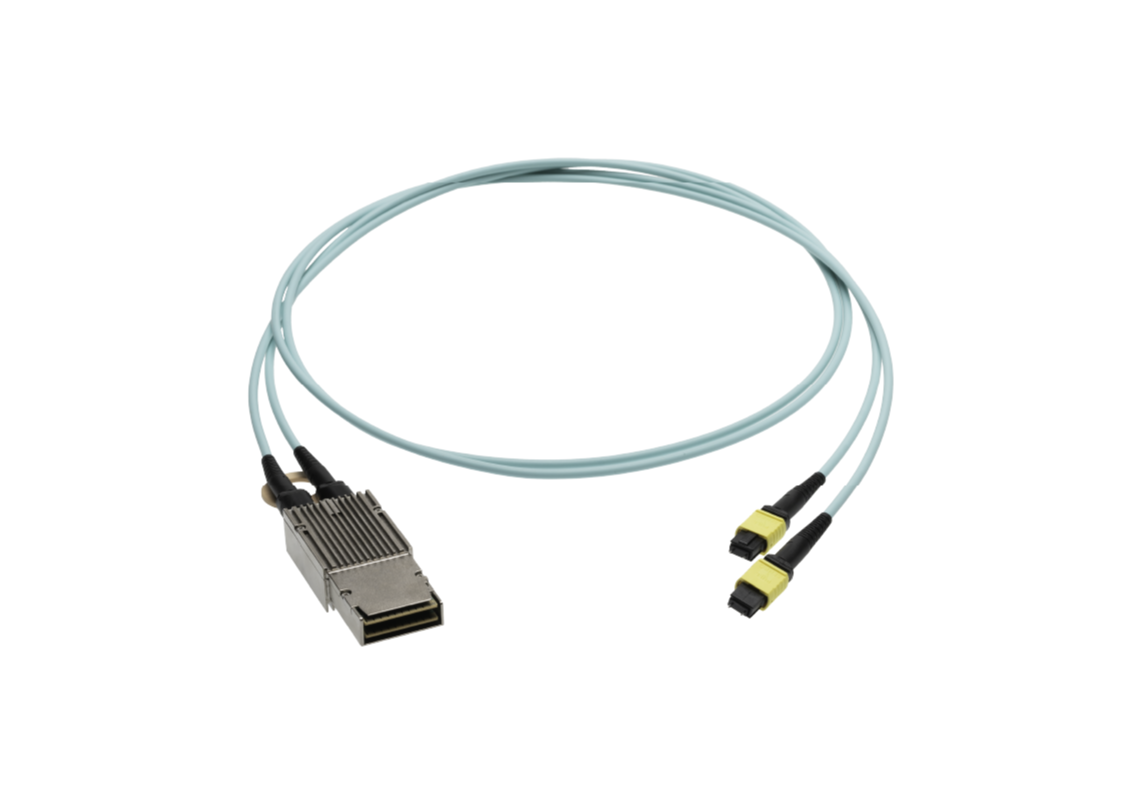
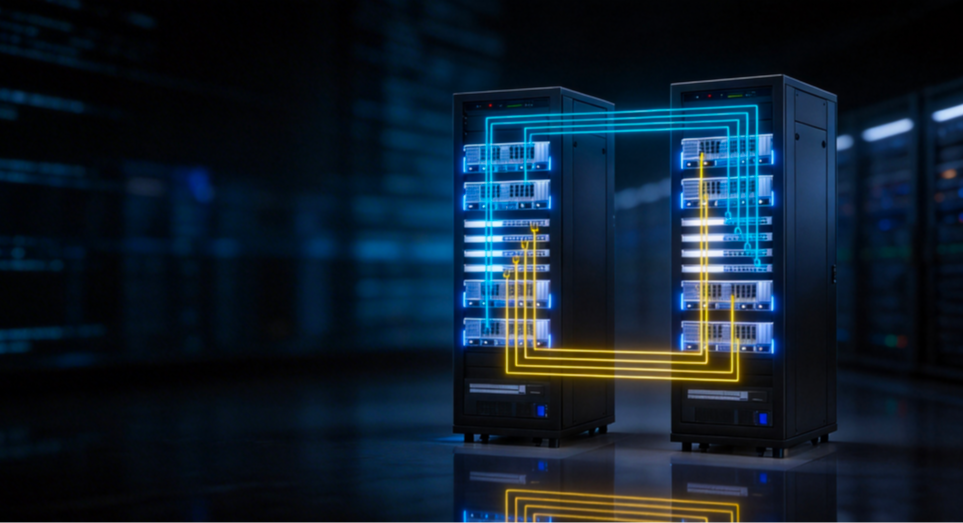
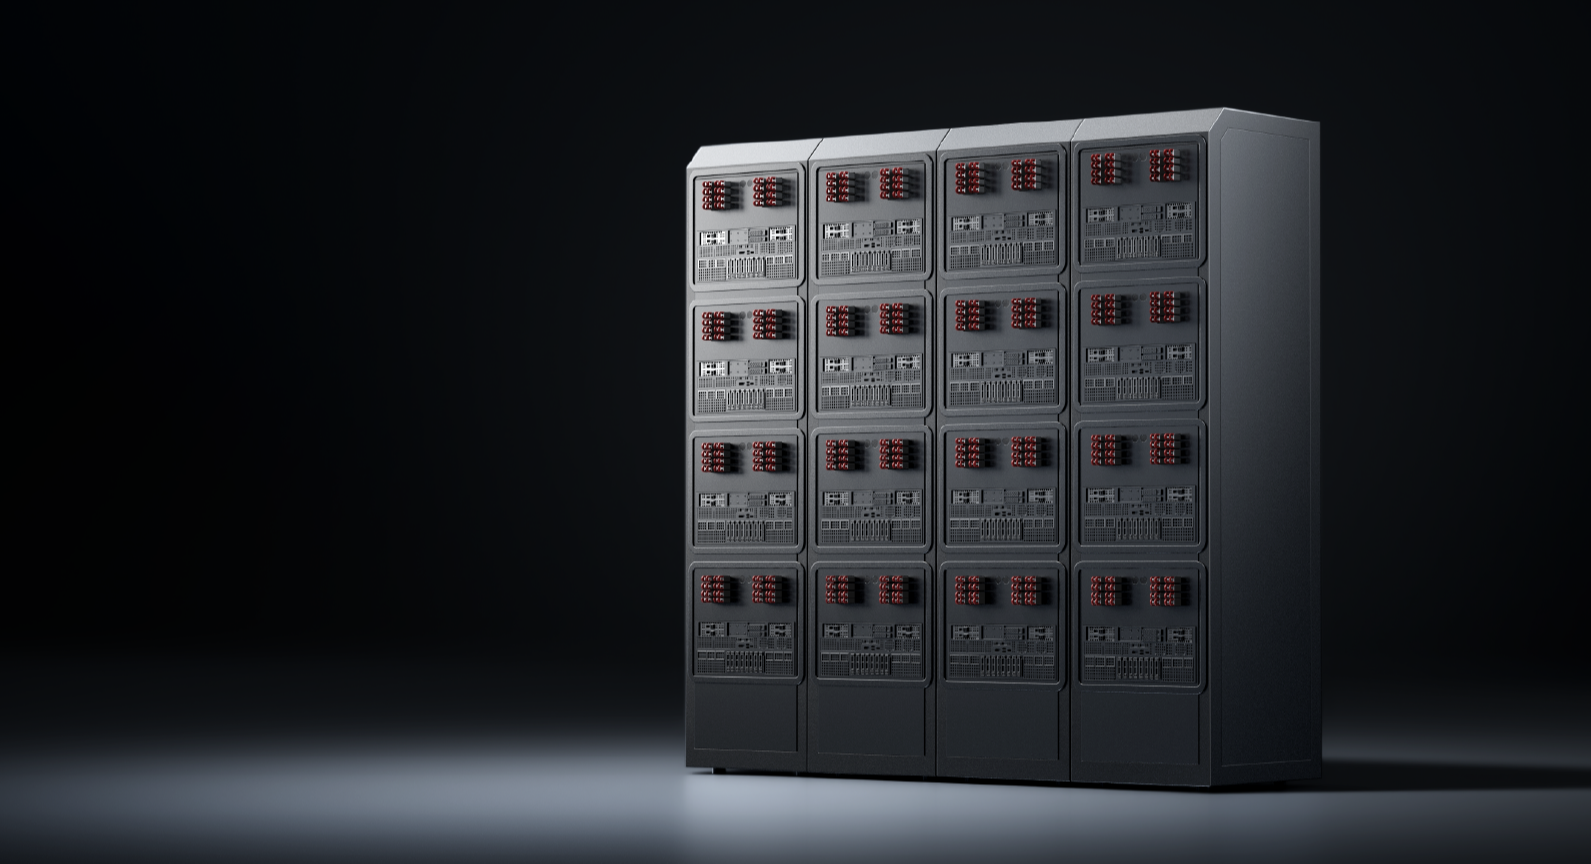
NPO领域: 作为从传统光模块过渡到CPO形态的关键中间步骤,当前,NPO对产业链扰动最小且需求最为迫切。NPO技术的核心价值在于移除了传统光模块中高功耗、高成本的DSP(数字信号处理)芯片。通过将光引擎移近主芯片,电信号传输距离大幅缩短,但这也意味着硅光芯片必须承担起原本由DSP完成的信号完整性保障重任,对发射功率、接收灵敏度及噪声控制提出了远超传统光模块的要求。 CPO领域: 面向更长远的演进,曦智科技同步展示了CPO光电共封装方案(交换机CPO应用原型)。 CPO虽对产业链良率和封装工艺提出严峻挑战,但业界普遍视其为光互连的终极形态。然而,CPO的大规模商用远不止芯片设计层面的突破,更依赖封装、测试、系统散热等全产业链的深度协同;与此同时,批量化产品要求光芯片和电芯片公司至少提前三年进行联合定义与设计,时间窗口极为关键。正因如此,曦智科技已率先联合国内主流晶圆厂、封装厂、交换芯片、光组件等供应链伙伴,持续推进国产CPO的产业化落地进程。 OCS领域: 曦智科技已走在行业前列。公司基于领先的分布式光交换(dOCS)技术的光跃LightSphere X超节点解决方案,现已成功实现数千卡集群的商业化部署,标志着中国首个商业化、自主研发的千卡级光交换计算集群正式建成。 目前,公司已推出下一代光交换电交换混合Scale-up网络解决方案:GPU机柜内部通过电交换实现高速互连,机柜之间则借助分布式光交换完成弹性扩展。相较传统方案,该架构时延低至百纳秒,硬件开放解耦、不绑定特定厂商,为大规模AI集群部署提供了更灵活、更高效的基础支撑。基于这一架构,集群可在多种拓扑形态间灵活切换,真正实现“一套硬件,按需变形”——既可将多个机柜聚合为一体,承载超大MoE模型训练任务,也能拆分为独立集群实现多租户隔离,最大化带宽利用效率。该方案显著降低集群总体拥有成本,是下一代AI超节点落地的重要技术路径。
在本届ODX大会,曦智科技的展示充分体现了:Scale-up光互连正从单点验证走向全面渗透。无论是近期备受行业关注的NPO技术、更为前瞻的CPO布局,还是dOCS集群互连范式的创新,曦智科技凭借其在硅光芯片设计领域的深厚积累及对计算互连的深刻理解,正在成为智算中心光互连技术革新的重要力量。
阅读推荐