






当模型把同一段网络跑两遍,光计算等到了自己的形状。
11月17日,商汤科技正式发布日日新 SenseNova Loop-9B模型。同日,曦智科技基于 PACE 2光电混合计算芯片的曦智天枢®光电智能计算卡顺利完成对该模型的Day 0深度适配——模型发布当日即完成从执行配置复现、算子映射适配、模型量化到端到端推理的全链路验证。
这也是曦智科技的光计算产品首次完成开源模型的day0适配,验证了曦智科技光计算产品软硬件一体化协同的能力,光计算的结构性优势得以愈加彰显,意味着曦智科技光计算产品朝着通用性的方向迈出了标志性的一步。
9B 的体重,14.6B 的算力
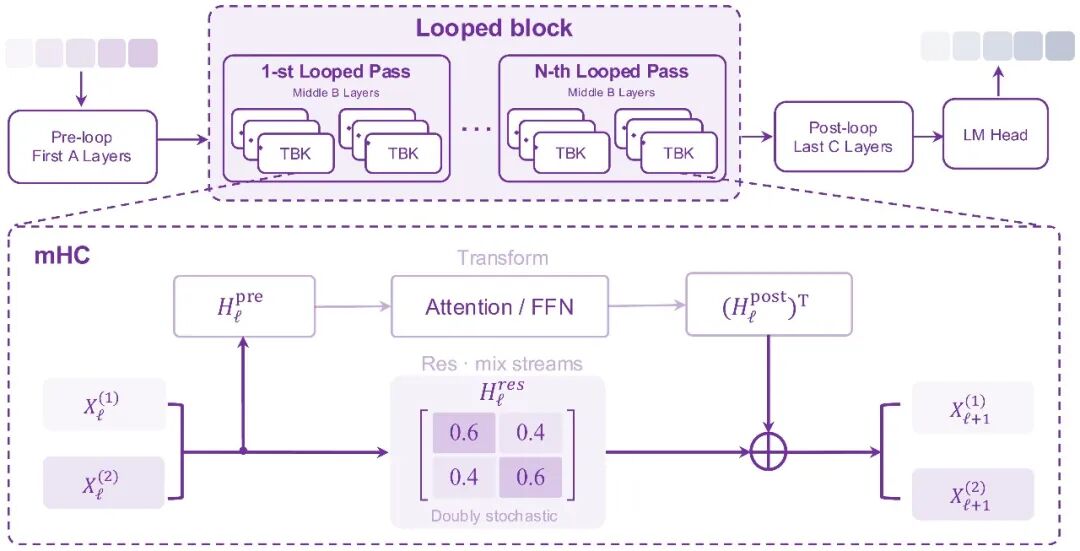
SenseNova Loop-9B模型,通过 Loop 结构复用模型层的参数,并结合流形约束超连接(mHC),在有限的参数规模下扩展计算深度,面向复杂推理、代码、工具调用和多模态任务;并且得益于 Loop 的高效循环结构,模型官方 4bit 量化后权重仅约 4.9GB,部署显存需求低至 10 GB内,能显著拓宽可部署的硬件范围。
该模型体现的是“不堆参数、堆执行深度”的路线:它以32层多模态解码器为基础,第4至27层共24层以共享权重连续执行两遍,一次前向完成56次解码层计算;存储参数约9B,推理等效参数约14.6B。换句话说,它用9B的“体重”,跑出了14.6B的“算力”,接近更大模型的表达能力。
“这种‘权重不变、算两遍’的结构,恰好把压力从存储挪到了计算——也正是光计算最擅长承接的那一端,”曦智科技光计算产品线总经理于山山博士介绍道。
对光计算而言,循环解码器是一个天然对口的负载:同一个权重块在一次前向里执行两遍,权重与光矩阵系数在整段循环中保持不变。数字芯片每层都要重新搬运权重,而可编程光矩阵只需在循环开始前配置一次,两遍执行之间不产生重配置开销。Loop-9B 的结构,恰好落在光计算最擅长的“计算密集、访存轻”区间。
软硬件协同,Day0深度配置
Day 0适配的门槛不在“能不能加载”。Loop-9B 的循环范围、执行遍数与双流 mHC 路由参数属于检查点执行配置的一部分,兼容的推理实现必须加载这些参数并复现相同执行顺序,不能被当作普通32层 Transformer 处理。
曦智天枢的适配沿两条线推进:
模型量化微调,把浮点权重和激活量化到光芯片可计算的定点数据类型,同时保证输出精度;
模型编译,由曦智编译器完成算子图编译和光电切分——线性注意力的投影与状态更新、前馈网络的 GEMM 放在光域,长上下文全注意力、Sinkhorn 归一化与路由计算留在电域,通过 oMAC 光矩阵加速算子与电芯片协同调度。
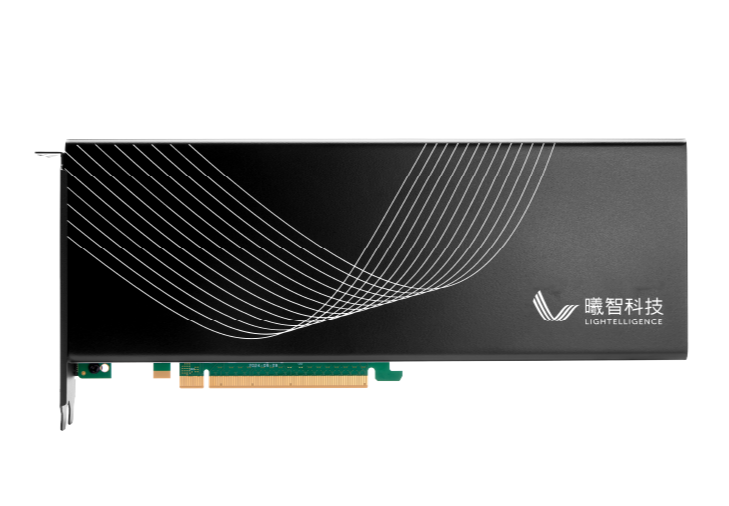
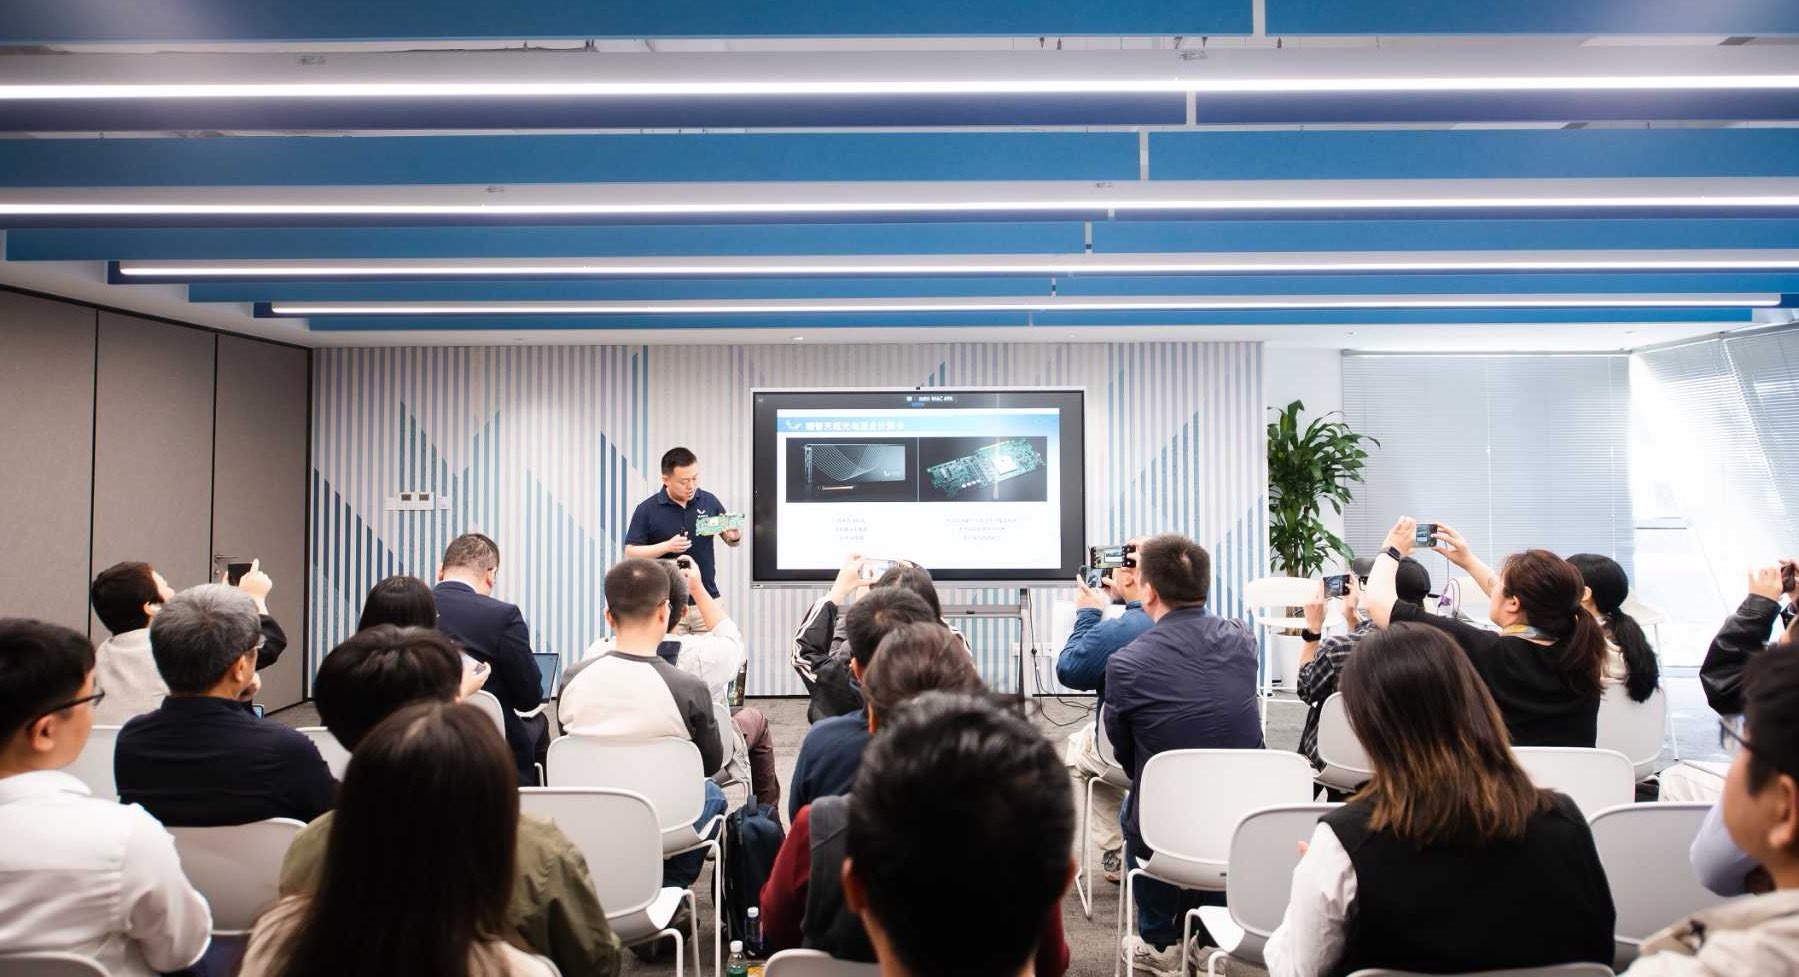
硬件层面,曦智天枢基于自研 PACE 2光电混合计算芯片,单芯片集成128×128光学矩阵、超过4万个光子器件,光子芯片面积600mm²,通过3D TSV 先进封装将硅光芯片与 CMOS 电芯片垂直互连;板卡内置光源,标准全高全长卡型与 PCIe Gen4×16接口,可直接插入现有服务器,与既有算力构成“电做调度和非线性、光做矩阵乘加”的异构推理系统。
产品化节奏:更多模型,更快链路
截至目前,曦智科技已累计完成Qwen、Step、Llama等多个主流模型的适配与验证,覆盖国内主流厂商的旗舰基座模型、轻量化模型与多模态模型,并延伸至 Ising、LineSolver 等科学计算类算子场景,适配速度与场景广度持续提升。
下一代光电混合计算芯片PACE 3已于2026年6月完成光芯片流片,光学矩阵规模提升至256×256,面向低延迟、高通量的大模型推理与多卡互连扩展,将进一步缩短“新模型—新算子—光矩阵映射”的链路。
从一次 Day 0适配,到一条可持续的产品化节奏,曦智科技表示,将继续与模型厂商、推理框架和整机伙伴推动适配机制,共建产业生态发展;让光计算在产业节奏中构筑越来越明晰的形态与未来。
模型开源链接
Github:


